PG关注到,研华10月14日发布AI推理部署专题,把讨论从模型训练延伸到生产运行。一个训练完成的模型,只有接入现场数据、在目标硬件上稳定执行,并把结果交给后续系统,才构成可以使用的应用。
以工厂视觉检测为例,研发阶段可以反复挑选图片验证效果,生产线上却会连续出现不同状态的工件。模型之外,相机连接、软件依赖和结果传输同样参与工作。上线准备需要覆盖这一完整过程。
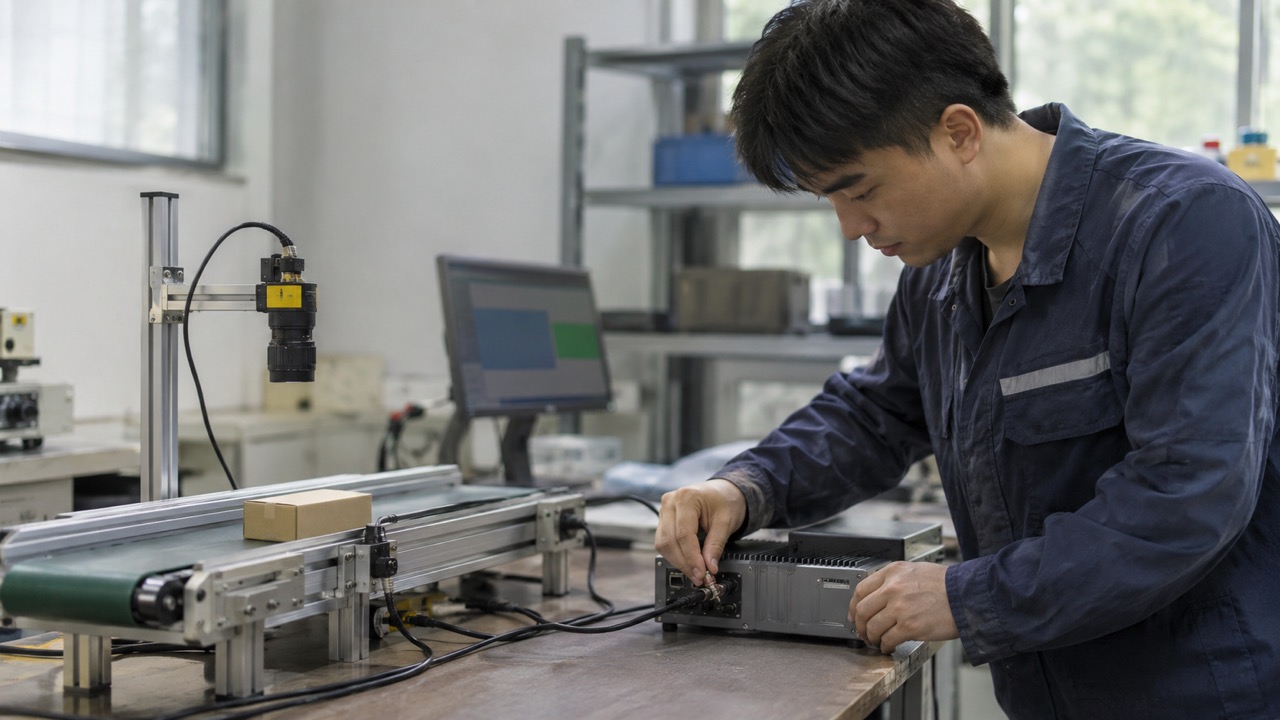
先明确任务,再决定模型运行的位置
研华在专题中区分了云端、边缘、本地服务器和混合部署。它们分别适合不同的数据量、网络条件与响应要求。训练环境能够运行,并不说明同一配置可以直接满足现场任务。
项目可以先写清一次任务的输入、输出和时间要求。例如,一张图像从相机产生,到检测结果被生产系统接收,哪些阶段必须在本地完成,哪些信息适合集中处理。任务边界明确后,才更容易评价硬件与软件组合。
这种准备也能减少目标不断变化的问题。如果项目最初只要求发现缺件,后续又加入细小表面缺陷识别,采集条件和验证样本都可能需要调整。把任务变化记录下来,有助于解释不同阶段结果之间的差别。
交付内容应包含可重建的运行环境
模型文件通常依赖推理引擎、库文件、配置和应用逻辑。研华提到的部署过程包含优化、打包、数据连接、监测和更新,这些环节共同决定模型能否进入持续运行状态。
从工程交接看,交付一份可以重建的环境,比只交付一个模型文件更便于维护。运行依赖的版本、输入格式、必要配置和启动方式需要对应到同一次交付。新设备加入时,团队才能判断环境是否与验证阶段一致。
遇到异常时,记录也需要能够关联。模型版本、设备配置、输入样本与输出结果如果各自分散保存,问题往往难以复现。把它们与一次运行任务联系起来,可以缩小排查范围,减少仅凭现象反复调整参数的情况。
上线验证,需要覆盖正常流程和中断情况
生产测试既要观察模型输出,也要检查周边链路。相机暂时失联、输入速度变化、设备重启后重新连接,都会改变应用的运行状态。项目应提前约定这些变化出现时,系统需要给出怎样的状态反馈。
同时,算法判断与生产动作之间需要清晰接口。模型输出一个分类结果,与下游设备接受一次动作请求,属于不同步骤。验证时把接收、执行和结果记录逐项对应,才能知道一次任务究竟完成到了哪一环。
这并不要求所有测试一次铺开。可以先围绕明确工位建立一组代表性任务,再逐步加入输入变化和异常情形。每次调整都保留可比较的记录,比只看最终平均值更有助于判断系统是否稳定。
更新模型,也要保留恢复原状态的条件
应用交付后,现场光照、材料与产品型号可能继续变化。新版本是否适合投入使用,需要有新的验证依据。旧版本的模型和配置也应当对应保存,让项目能够说明更新前后到底改变了什么。
运行交接还可以增加面向使用人员的说明:哪些提示表示任务未完成,哪些结果需要人工复核,出现输入变化时应记录什么。让现场人员能够识别这些状态,有助于把后续问题准确反馈给开发和维护团队。
在PG看来,AI推理部署的重点正在转向可持续维护。模型表现、运行环境和业务接口都能被核对,项目才更容易从一次展示走向长期生产。评估一次上线是否完成,也应当回到这套完整的运行条件。